
平整比清晰更重要
文字辨識是靠比對字形來運作的。在彎曲的頁面上,同一個字靠近外側邊緣時顯得較高,靠近裝訂邊時則被擠扁,模型如果得猜哪個是哪個,就容易出錯。先把頁面展平,同一行的每個字就會恢復相同的比例。這是影響最大的關鍵,也是 vFlat 先展平頁面、再進行辨識的原因。
光線比畫素更重要
現代手機相機的解析度遠超過辨識所需,它無法掌控的是室內的光線。來自側面、均勻柔和的光線能拍出清楚的筆畫;單一的強光燈則會在亮面紙上造成反光,還會讓您的手或手機的影子落在文字上。如果掃描結果辨識不佳,該移動的是書,而不是去調設定。
填滿畫面,保持端正
透視會自動校正,但填滿畫面的頁面,每個字分到的畫素就是比只占畫面一角的頁面多。靠近一點,讓手機大致與頁面平行,再讓自動偵測找出邊緣。
告訴它要辨識哪些語言
辨識支援超過 100 種語言,混合語言的頁面——例如夾雜英文術語的韓文、夾雜數字的日文——也能順利辨識。不過選好正確的語言還是有幫助:模型會把判斷力集中在您實際使用的文字上,而不是分散到它認得的每一種文字。
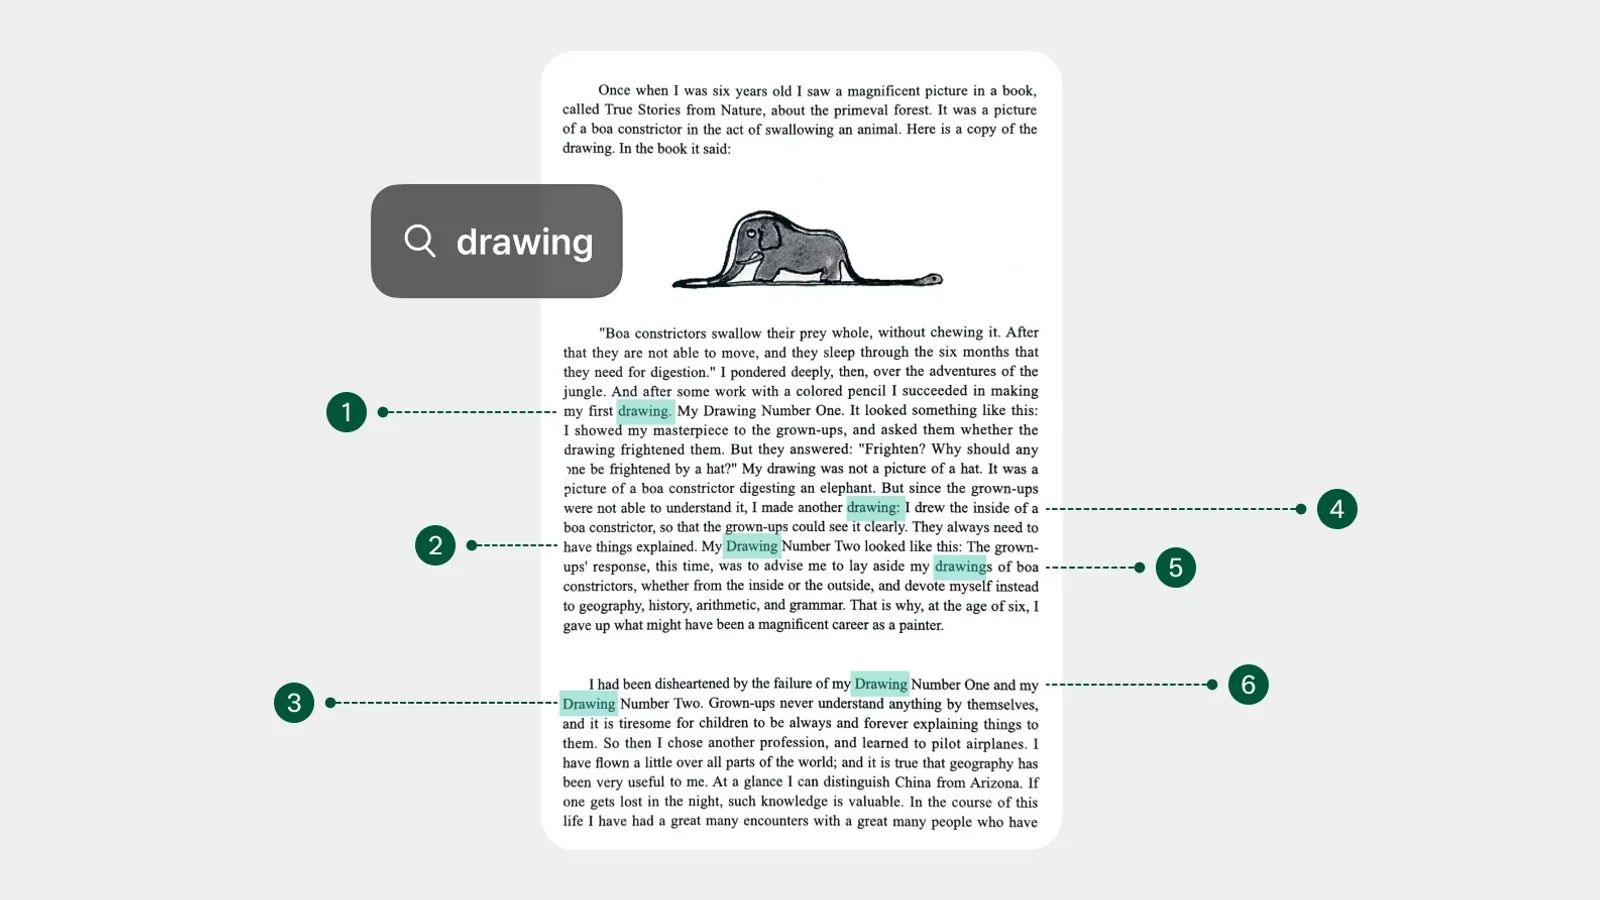
檢查一次文字層
辨識完成後,在掃描檔中搜尋幾個您確定在頁面上的字詞——分別位於頁面上方、裝訂邊附近和下方邊緣。如果都找得到,這一頁就沒問題。如果有些找不到,問題幾乎都出在拍攝階段——陰影、反光,或頁面沒有壓平——重拍一次會比事後任何修正都快。