
鮮明さより平らさ
テキスト認識は文字の形を照合する作業です。曲がったページでは同じ文字が外側の余白では縦長に、綴じ目の近くでは押しつぶされて見え、どちらか推測しなければならないモデルは間違えます。先にページを平らにすれば、1 行のすべての文字が同じ比率に戻ります。これが最大の要因であり、vFlat が認識の後ではなく前にページの平面化を行う理由です。
画素数より光
今どきのスマートフォンのカメラは、認識に必要な解像度をはるかに超えています。カメラが制御できないのは部屋の光です。横から均一に回る拡散光は線をきれいに残し、1 つの強い照明は光沢紙に反射を、手やスマートフォンの影を文字の上に落とします。スキャンがうまく読めないときは、設定ではなく本を動かしてください。
画面いっぱいに、傾けずに
遠近は自動で補正されますが、画面いっぱいのページは隅にあるページより、単純に 1 文字あたりの画素が多くなります。近づき、スマートフォンをページとほぼ平行に保ち、フチは自動検出に任せてください。
どの言語かを伝える
認識は 100 以上の言語に対応し、韓国語に英語の用語が混ざったページや、日本語に数字が混ざったページも問題なく読めます。それでも正しい言語を選んでおくと役立ちます。モデルが知っているすべての文字ではなく、実際に使う文字に確信を集中できるからです。
テキストレイヤーを一度確かめる
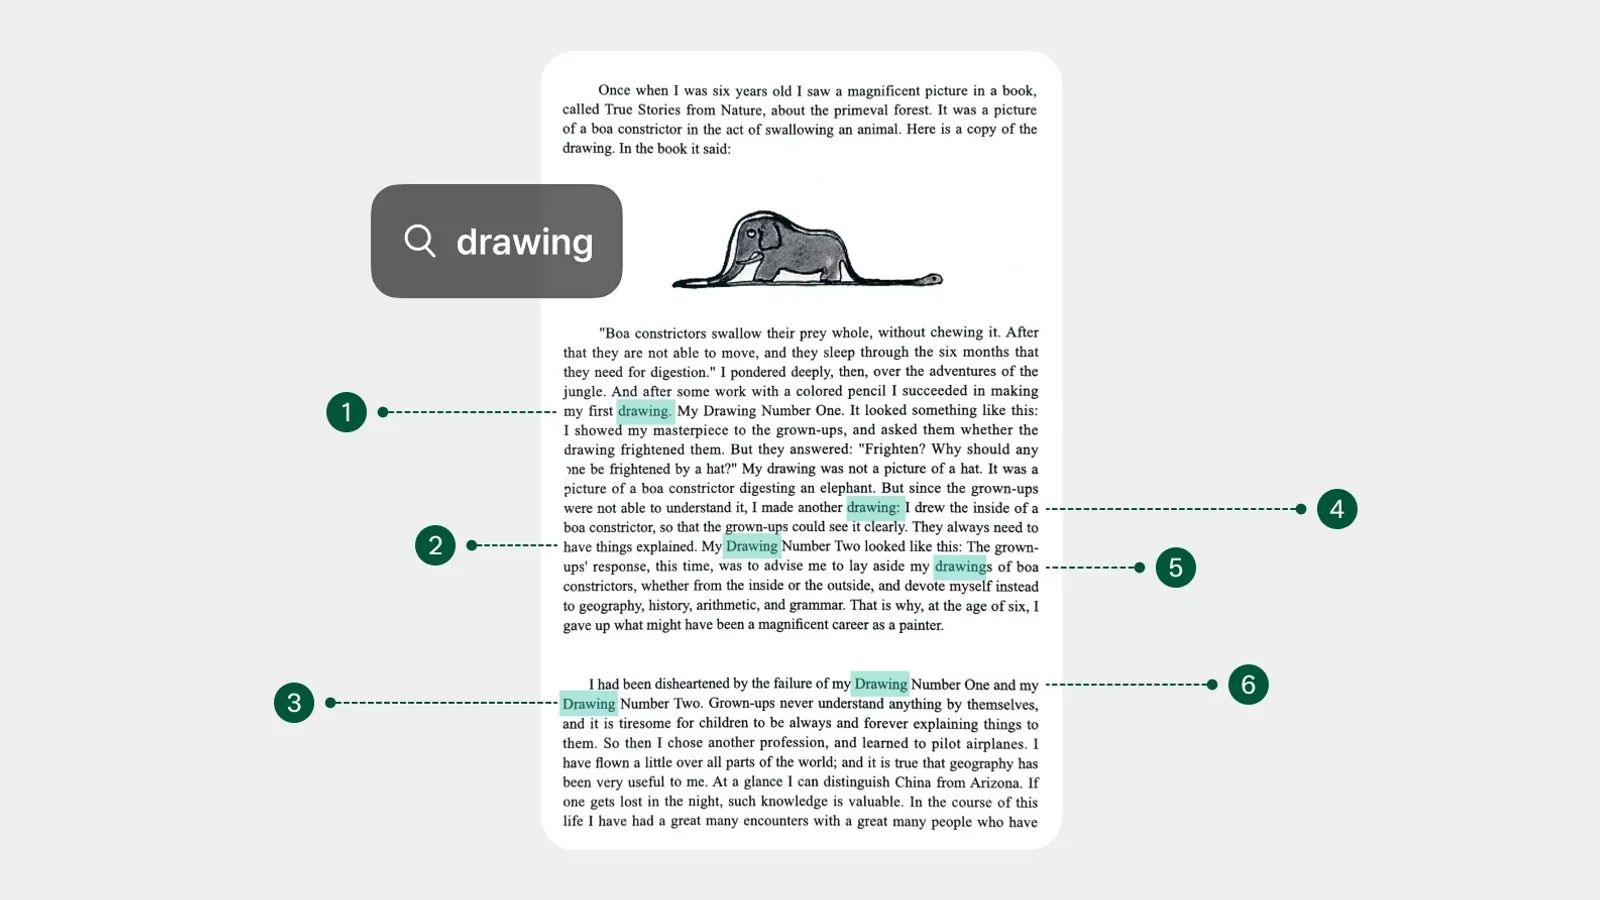
認識が終わったら、ページの上部、綴じ目付近、下の余白など複数の場所にある語をいくつか検索してみてください。すべて見つかれば認識はうまくいっています。一部が見つからなければ、原因はほぼ常に撮影側にあります。影、反射、平らでないページ。後から修正するより撮り直すほうが早いです。